METR detecta modelos internos no publicados de Anthropic: la frontera real va por delante de la que podemos usar
🕒 Publicado en Zendoric: 7 de noviembre de 2026 · 00:30
✨ Generado con IA · cómo se hace
METR afirma haber identificado modelos internos de Anthropic que aún no se han publicado. El que más puntúa, llamado «Model 4», supera el 50% en todos los benchmarks evaluados. El dato importa menos por la cifra que por lo que revela: lo que se publica no es necesariamente lo más avanzado que existe.
📚 Para profundizar

El cofundador de DeepMind sobre el dilema de contener tecnologías que no quieren ser contenidas.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
El hecho, según la nota de la que partimos: METR identificó varios modelos internos de Anthropic que no se han hecho públicos. METR (Model Evaluation and Threat Research) es una organización independiente que evalúa capacidades y riesgos de los modelos de IA. Entre esos modelos destaca uno llamado «Model 4», que según METR obtiene la mejor puntuación y supera el 50% en todos los benchmarks evaluados.
Hay que ser prudentes. La nota no dice qué benchmarks se usaron, cuál es su dificultad ni cómo se compara ese 50% con los modelos ya publicados. Tampoco explica cómo se «identificaron» esos modelos ni si Anthropic los ha confirmado. Sin esos datos, el titular no permite saber cuánto ventaja real hay. Superar el 50% puede ser mucho en una prueba no saturada y poco en una que ya está cerca del techo.
Aun así, el fondo es relevante. Confirma algo que el sector da por supuesto pero pocas veces puede ver: los laboratorios entrenan y evalúan internamente modelos que van por delante de los que comercializan. La frontera pública es un retrato con retraso de la frontera real.
Nuestra lectura: que sea un evaluador externo como METR quien mida estos modelos antes de su lanzamiento es, en principio, una buena noticia de gobernanza. Es el tipo de supervisión basada en evidencia que defendemos frente a regular el pánico. La pregunta incómoda es otra: si las capacidades decisivas se quedan dentro de las empresas durante meses, el debate público y regulatorio siempre llega tarde. A largo plazo, que haya más capacidad en reserva acerca los avances que pueden transformar la ciencia y la salud. A corto plazo, exige transparencia sobre qué se evalúa, con qué pruebas y quién decide cuándo sale. Esperaremos a conocer los benchmarks concretos antes de sacar conclusiones sobre el «Model 4».
📚 Para profundizar

Veinte años después de «La singularidad está cerca», Kurzweil revisa sus predicciones y mantiene la fecha: fusión humano-IA hacia 2045.
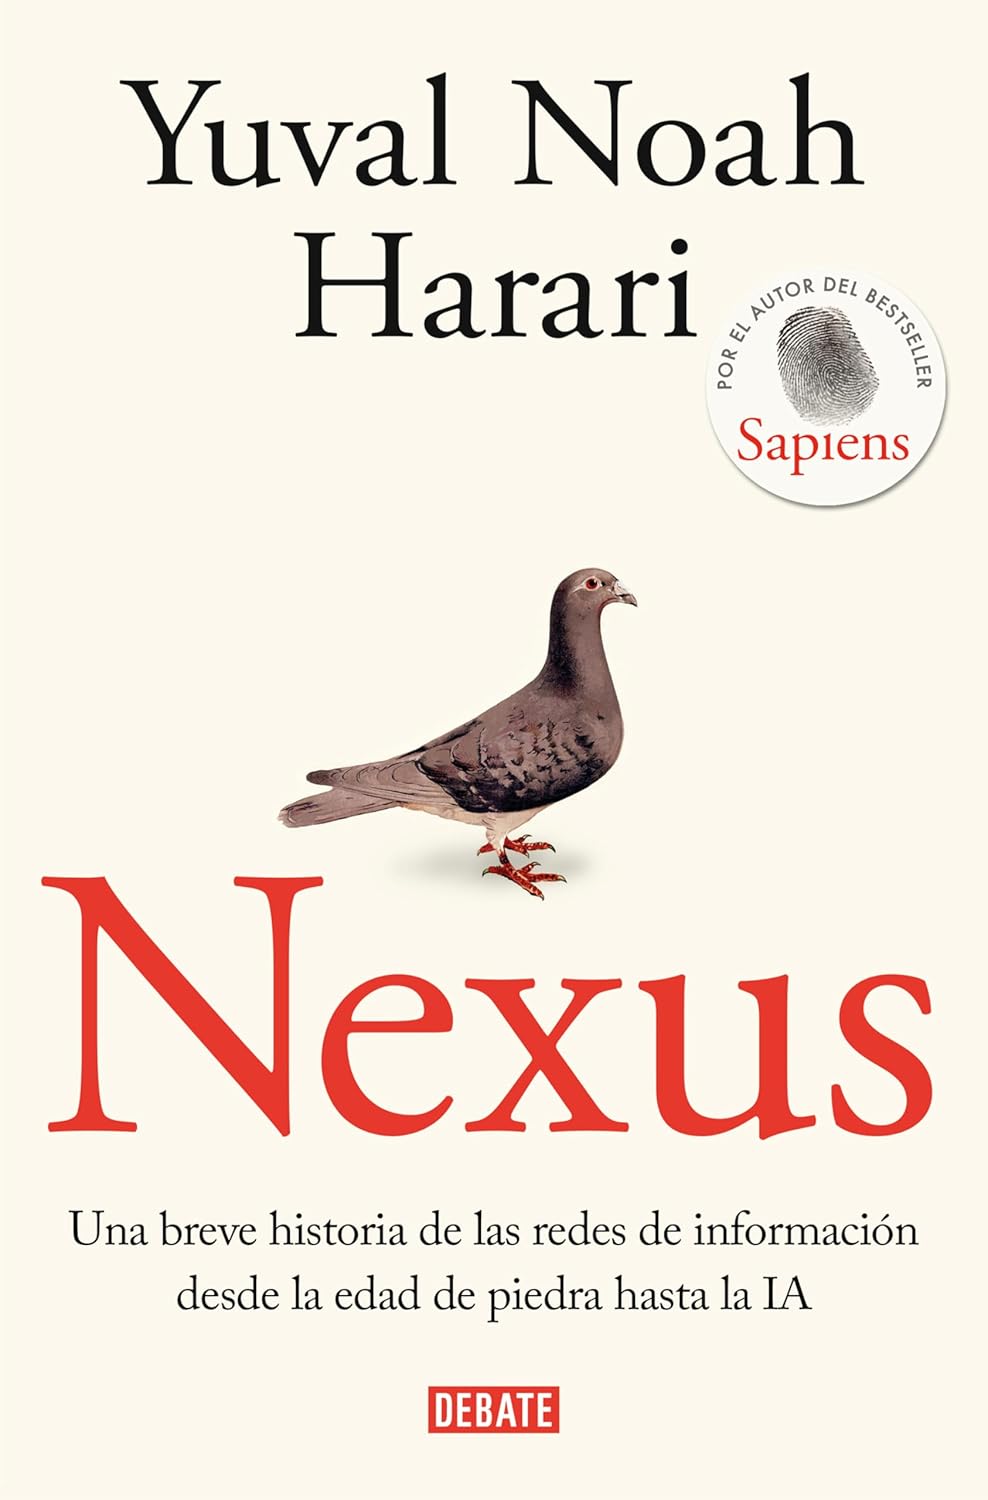
La IA vista como el último capítulo de la historia de las redes de información, del chisme a la imprenta al algoritmo.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- Anthropic descubre el 'J-space': un espacio de trabajo global oculto donde Claude piensa sin decirlo · 2026-07-08
- GPT-6 saca más de un 10% a Fable 5.1 en benchmarks: por qué esa cifra dice menos de lo que parece · 2026-09-12
- Meta dice haber alcanzado la frontera con Muse Wonder: hasta que lo confirmen benchmarks independientes, es solo una promesa · 2026-10-13