GPT-6 saca más de un 10% a Fable 5.1 en benchmarks: por qué esa cifra dice menos de lo que parece
🕒 Publicado en Zendoric: 12 de septiembre de 2026 · 13:31
✨ Generado con IA · cómo se hace
OpenAI presenta GPT-6 y, según las cifras del lanzamiento, supera con claridad a GPT-5.6 Sol y a Fable 5.1, con más de un 10% de ventaja en benchmarks sobre el modelo de Anthropic. Si se confirma, la corona de la frontera cambia de manos otra vez. Pero un 10% agregado sobre pruebas medio saturadas no es lo mismo que un 10% de capacidad real: conviene saber de dónde sale ese número.
📚 Para profundizar

La investigación periodística definitiva sobre OpenAI: más de 260 entrevistas, el choque entre seguridad y velocidad, y el intento de despido de Sam A
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
Los hechos, primero. Se ha presentado GPT-6, la nueva generación de la familia de OpenAI, y las cifras difundidas en el lanzamiento lo sitúan por encima tanto de su predecesor GPT-5.6 Sol como de Fable 5.1, el modelo frontera de Anthropic. La ventaja declarada sobre Fable 5.1 supera el 10% en las pruebas de rendimiento —los llamados benchmarks: baterías estandarizadas de tareas con las que se compara modelos entre sí—. Es, tal y como se presenta, un cambio de liderazgo en la frontera. Con una cautela importante: son cifras de la propia presentación, no de una evaluación independiente.
El contexto explica por qué el dato tendría peso. En nuestro Índice de Calidad Zendoric, la familia Fable venía liderando con holgura: 90 puntos frente a los 79 de GPT-5.6 Sol, unos once puntos de distancia que no era ruido, era una brecha. Que OpenAI no solo recorte esa diferencia sino que la invierta —y frente a la actualización 5.1, no frente al modelo base— implicaría uno de los relevos más rápidos que hemos visto en el primer puesto. Detrás, el pelotón chino (GLM-5.2 en 77, Qwen3.7-Max en 73) sigue empujando desde el open-weight.
Ahora el matiz, que es donde está el análisis. Un 10% agregado no es un 10% de capacidad. Llevamos meses insistiendo en lo mismo: los leaderboards clásicos están saturados, con varios modelos rozando el techo en las pruebas más conocidas. Cuando eso ocurre, las mejoras de titular tienden a concentrarse en lo que ya estaba casi resuelto, mientras lo que de verdad discrimina —el trabajo largo, ambiguo y desordenado, las tareas expertas sin guía, la fiabilidad a lo largo de horas— apenas se mueve. Sin saber qué pruebas componen ese porcentaje, el número es una promesa, no una medición.
Para quien usa estos modelos a diario, además, el ranking rara vez es lo decisivo. Lo que cambia el día a día es el precio por token, la latencia, la tasa de alucinación en el dominio concreto y si el proveedor aguanta en pie —recordemos la caída casi simultánea de tres laboratorios el pasado septiembre—. Un 10% en benchmark puede ser invisible en producción; un 30% más barato, no.
Nuestra lectura: la noticia relevante no es quién va primero, sino lo poco que dura ir primero. Ningún laboratorio ha conseguido sostener el liderazgo más de unos meses, y eso significa que no hay foso defendible: la capacidad de frontera se está convirtiendo en un bien que se abarata y se difunde a velocidad incómoda para los márgenes de las empresas y muy favorable para todos los demás. Esa es exactamente la dinámica que hace pensable el horizonte largo —diagnóstico y descubrimiento de fármacos al alcance de cualquier laboratorio, no solo de cinco compañías—. A corto plazo, lo que toca es más aburrido y más necesario: exigir que el 10% venga con el desglose, y que alguien ajeno a OpenAI lo verifique. Cuando falta el termómetro, el anuncio acaba sustituyendo a la prueba.
📚 Para profundizar

El cofundador de DeepMind sobre el dilema de contener tecnologías que no quieren ser contenidas.
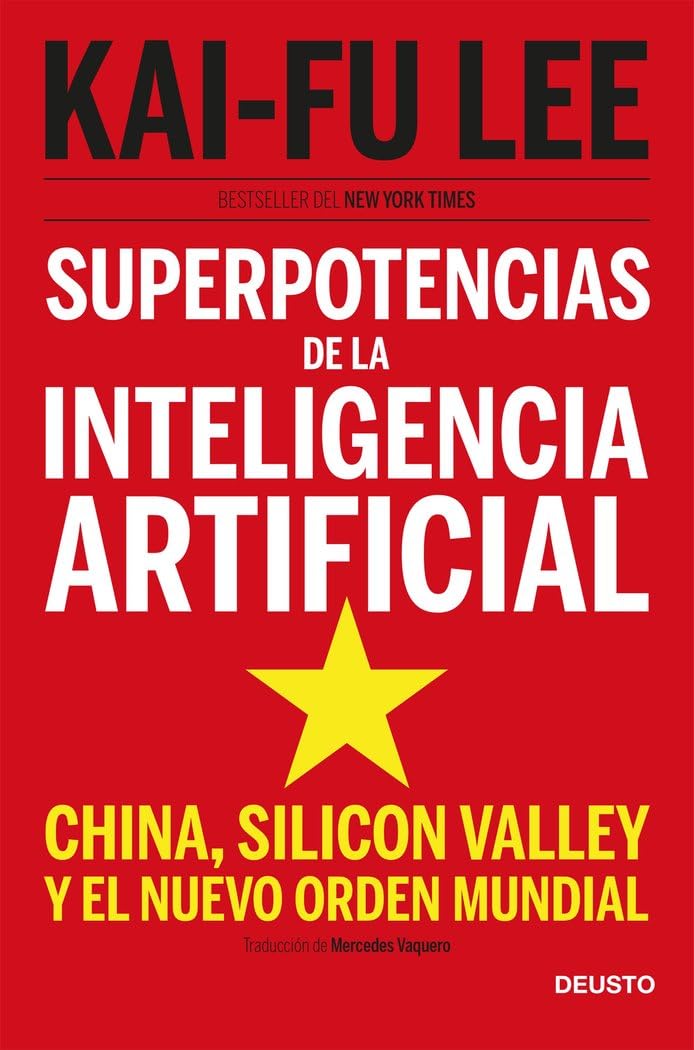
China contra Silicon Valley contado por quien dirigió Google China y ha invertido en ambos lados.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- GPT-6 llega diciendo que gana a Fable 5.1 por más de un 10%: si el dato aguanta, se invierte el liderazgo · 2026-09-09
- GPT-6 recupera el liderazgo para OpenAI: un +10% que hay que verificar antes de celebrarlo · 2026-09-13
- Kimi K3 gana en front-end con 2,8 billones de parámetros: el open-weight chino aprieta la frontera · 2026-07-19