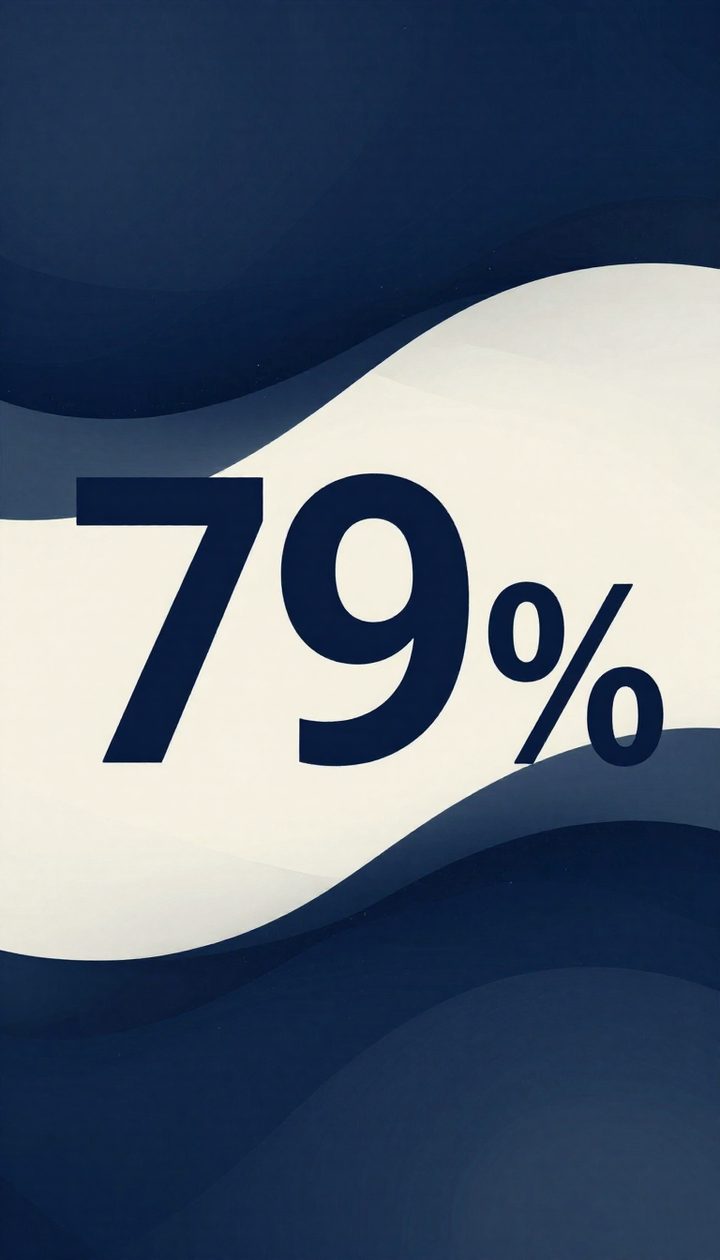
El 79% de las empresas admite que sus GPU están ociosas al menos la mitad del tiempo, pero la mayoría planea nuevas plataformas de IA
🕒 Publicado en Zendoric: 27 de octubre de 2026 · 00:16
✨ Generado con IA · cómo se hace
VentureBeat Intelligence publica datos según los cuales la mayoría de las empresas encuestadas que ejecutan IA en producción tienen GPU que permanecen ociosas al menos la mitad del tiempo, y aun así la mayoría planea añadir o cambiar de plataforma de cómputo de IA en los próximos 12 meses.
📚 Para profundizar

El cofundador de DeepMind sobre el dilema de contener tecnologías que no quieren ser contenidas.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
VentureBeat Intelligence publica datos según los cuales la mayoría de las empresas encuestadas que ejecutan IA en producción tienen GPU que permanecen ociosas al menos la mitad del tiempo, y aun así la mayoría planea añadir o cambiar de plataforma de cómputo de IA en los próximos 12 meses. El artículo, firmado por Matt Marshall y fechado el 23 de octubre de 2026, agrupa tres encuestas mensuales VB Pulse (julio, agosto y septiembre de 2026).
Las cifras principales: el 79% de los 218 encuestados que informaron de su utilización de GPU (172 de 218) dijo que sus GPU están ocupadas la mitad del tiempo o menos. La proporción se mantuvo entre el 77% y el 81% en cada uno de los tres meses. Entre esas empresas con GPU ociosas, el 70% (120 de 172) planea adoptar una plataforma de cómputo de IA nueva, adicional o de reemplazo en los próximos 12 meses. Entre las empresas con GPU ocupadas más de la mitad del tiempo, el porcentaje es del 74% (34 de 46), una diferencia que el medio califica de estadísticamente no significativa.
El contexto es el debate sobre si la IA es una burbuja. El texto recuerda que el 13 de octubre el Fondo Monetario Internacional advirtió de que una fuerte caída de las acciones de IA podría amenazar la estabilidad financiera global. Según el autor, la discusión se ha centrado en los vendedores de cómputo (Nvidia, Microsoft, Google, AWS, CoreWeave), mientras que esta encuesta mira lo que hacen sus clientes. Su tesis es que «la burbuja está dentro de la empresa»: la demanda de IA es real y sigue creciendo, sobre todo hacia los modelos de frontera de Anthropic y OpenAI, pero las empresas pagan por dos tipos de IA que no son fácilmente sustituibles.
El primero es la capacidad: el autor cree que muchas compañías, asustadas por las noticias de escasez de GPU en 2024 y 2025, aseguraron capacidad para no quedarse cortas. Matiza que las encuestas no preguntaron cómo obtuvieron esa capacidad ni si la controlaban directamente. El segundo son los modelos de frontera de Anthropic, OpenAI y Google, pagados por token vía API, por suscripción o a través de grandes nubes. Los modelos GPT y Claude son cerrados: los ejecuta el proveedor o el fabricante en su propia infraestructura, por lo que una empresa no puede cargarlos en GPU que ya controla. Para aprovechar esas GPU habría que pasar a un modelo de pesos abiertos y operarlo uno mismo, lo que exige trabajo de ingeniería real. En las pruebas propias de VentureBeat en octubre, DeepSeek fue el más barato de cinco modelos abiertos, pero muchas empresas son reacias a depender de modelos chinos como caballo de batalla.
Como ejemplo de presión de costes, el artículo cita al CTO de Uber, Praveen Neppalli Naga, quien dijo en agosto que «estamos llegando al final de la llamada era del tokenmaxxing», tras agotar el presupuesto de IA de 2026 en pocos meses, según Fortune. Un responsable de IA de una empresa Fortune 500, que habló bajo condición de anonimato, dijo que los costes siguen subiendo y que la empresa espera compensarlos con productividad, aunque aún no lo sabe.
Los datos encajan con esa lectura en varios puntos. Entre las empresas con GPU ociosas que planean una nueva plataforma, el 90% (108 de 120) citó una plataforma en la nube o un proveedor de modelos entre sus opciones, y solo el 8% (9 de 120) mencionó un clúster de GPU propio o colocalizado, o una pila de código abierto autogestionada. Además, las empresas que ejecutan su propia pila reportan mejor utilización: el 56% (18 de 32) tiene GPU ociosas al menos la mitad del tiempo, frente al 83% (154 de 186) del resto. No se preguntó el motivo; la conjetura del autor es que quien gestiona su pila ve cada hora ociosa y tiene ingenieros para llenarla. Por último, en la encuesta de septiembre el 91% (58 de 64) de las empresas que planean una nueva plataforma no tenía una cifra de retorno de la inversión revisada por finanzas. El autor reconoce que parte de la capacidad ociosa puede ser deliberada (reserva para picos de demanda) y que una plataforma nueva puede sustituir a una antigua.
El artículo sostiene que los próximos ahorros estarán en tokens, contexto y agentes. Espera que una proporción creciente del gasto vaya al uso de modelos, porque los agentes planifican y ejecutan tareas de varios pasos. Cita una predicción de Gartner según la cual el coste de inferencia por flujo de trabajo agéntico se multiplicará por más de cinco hasta 2028. El precio por token baja, pero los agentes consumen muchos más tokens. La mayor parte de los tokens de un agente de programación es contexto que se relee en cada paso, de ahí la importancia de la caché: según una guía técnica de dos ingenieros de Nvidia publicada en marzo, tras la primera llamada en una sesión de Claude Code las siguientes reutilizan entre el 85% y el 97% del contexto desde caché, y Anthropic cobra entre una cuarentava y una décima parte del precio normal de entrada por los tokens en caché, según el modelo. Sobre los equipos de agentes, Vals AI indica que un agente líder con hasta cinco subagentes cuesta entre 1,8 y 5,1 veces más que un agente solo, y solo una de cuatro configuraciones mejoró las puntuaciones de forma estadísticamente significativa.
La recomendación en seis puntos: medir el coste por tarea completada (capacidad de GPU y gasto en API); probar qué modelo y nivel de esfuerzo fijar por defecto, juzgando por coste por tarea terminada y no por precio por token; enviar a cada agente solo el contexto necesario y cachear el repetido; añadir un segundo agente solo cuando la tarea se divida en partes paralelas; mover el trabajo rutinario y de alto volumen (clasificación, extracción, resumen) de las API de frontera a modelos abiertos en capacidad ociosa; y llenar las horas de GPU restantes con trabajo aplazable, como inferencia por lotes, evaluaciones y ajuste fino.
El texto también promociona la Agentic Infrastructure Stack Summit de VentureBeat, el 28 de octubre en San Francisco, con el lema «Los agentes más inteligentes necesitan más memoria. Los mejores equipos usarán menos». Participan ponentes de T-Mobile, WEKA, PayPal, Box, Adobe, Cisco (Outshift), Artificial Analysis, Uber, Upwork y Microsoft, entre otros; patrocinan WEKA, Outshift by Cisco y OneTrust.
Cautelas metodológicas: se agruparon 385 encuestados cualificados de organizaciones con 100 o más empleados. Cada mes participó un grupo distinto y autoseleccionado de lectores y panelistas de VentureBeat, por lo que los resultados describen a esos encuestados y no a todas las empresas. Los datos de utilización excluyen a quienes no miden el uso de GPU o no operan GPU. Algunas diferencias entre grupos (como 56% frente a 83%) se basan en muestras pequeñas, y la significación estadística se fijó en p < 0,05. Las conclusiones sobre las causas son interpretaciones del autor, no resultados medidos directamente por la encuesta.
📚 Para profundizar
El mejor libro para empezar si no eres técnico: un profesor de Wharton explica cómo trabajar CON la IA —cuándo delegar, cuándo supervisar, cuándo ni t

La investigación periodística definitiva sobre OpenAI: más de 260 entrevistas, el choque entre seguridad y velocidad, y el intento de despido de Sam A
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- El índice económico de Anthropic revela que la IA ya hace la mitad del trabajo… pero sus datos tienen un punto ciego enorme · 2026-06-29
- Una llave, cinco agentes: por qué el 69% de las empresas no sabría decir cuál de sus IAs falló · 2026-07-10
- Por qué los agentes de IA fallan con confianza: no es el modelo ni el contexto, es la ingeniería de datos · 2026-07-24