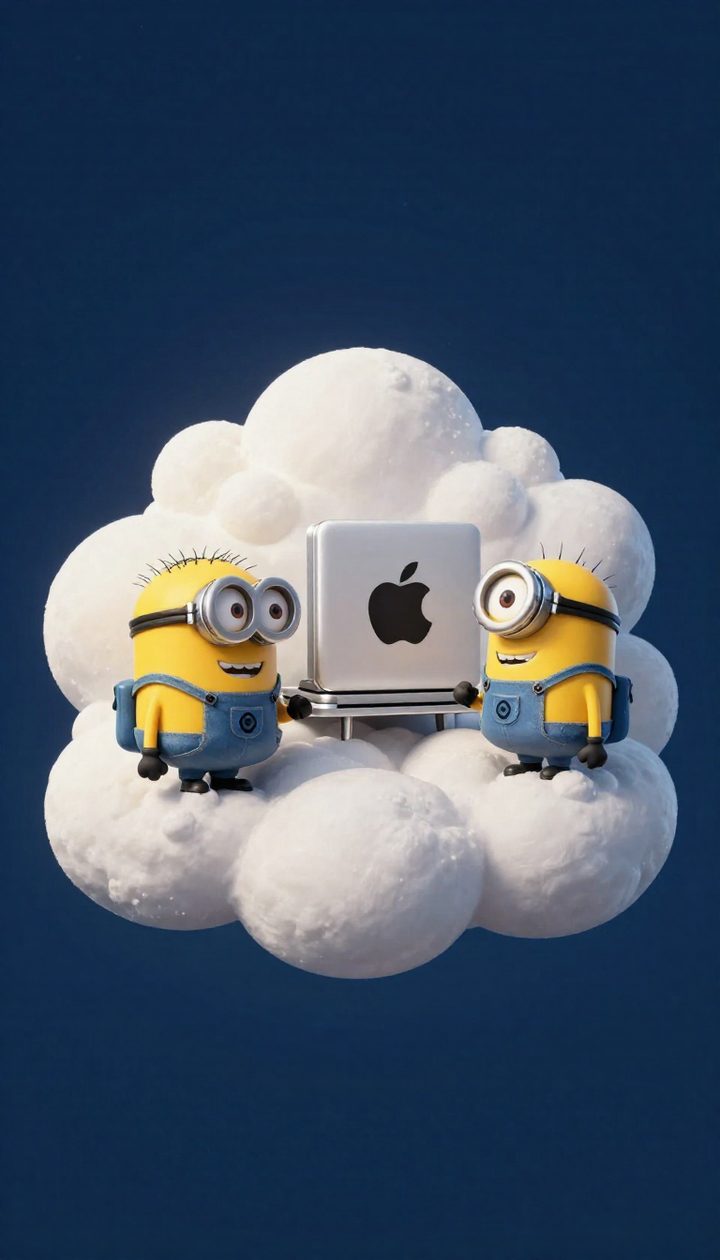
Minions: una nube de GPU virtual que agrupa los Mac inactivos con Apple Silicon para ejecutar inferencia
🕒 Publicado en Zendoric: 15 de octubre de 2026 · 00:13
✨ Generado con IA · cómo se hace
Lo que se descargó es solo la página de resumen (abstract) del artículo en arXiv, no el texto completo. Por eso este análisis es breve y se limita a lo que aparece en esa ficha. El propio artículo es muy corto: según los metadatos, tiene 3 páginas, 1 figura y 1 tabla.
📚 Para profundizar

La historia de NVIDIA y Jensen Huang: cómo una empresa de tarjetas para videojuegos acabó fabricando el recurso más codiciado del planeta.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
Lo que se descargó es solo la página de resumen (abstract) del artículo en arXiv, no el texto completo. Por eso este análisis es breve y se limita a lo que aparece en esa ficha. El propio artículo es muy corto: según los metadatos, tiene 3 páginas, 1 figura y 1 tabla.
El trabajo se titula «Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon Devices». Lo firman Jianhua Li, Yun Xing, Girisha De Silva, Ryan Flint, Kai Yuan y Sean Suchter. Se envió el 9 de octubre de 2026 a arXiv (identificador 2610.12970), en la categoría de Computación Distribuida, Paralela y en Clúster (cs.DC), con Aprendizaje Automático (cs.LG) como categoría secundaria.
El planteamiento parte de un problema conocido. La demanda de inferencia de aprendizaje automático acelerada por GPU ha dejado ver los límites de las infraestructuras centralizadas de GPU. El resumen menciona el coste elevado, la elasticidad limitada y los largos tiempos de espera cuando los recursos escasean.
Los autores señalan que las GPU de los dispositivos macOS con Apple Silicon son potentes y que, en el uso normal, permanecen en gran parte inactivas. Minions se presenta como una nube de GPU virtual, dinámica y distribuida, que agrega esas GPU inactivas de varios equipos macOS. Con ella se ejecutarían cargas de inferencia de aprendizaje automático a gran escala.
Según el resumen, la propuesta permite a los equipos aprovechar el hardware que ya tienen, sin comprar GPU adicionales. El sistema ofrecería ejecución flexible de tareas de inferencia en GPU, tolerancia a fallos y uso eficiente de los recursos.
La conclusión que ofrecen los autores es cualitativa. Afirman que su experiencia muestra que los dispositivos macOS inactivos pueden convertirse en una plataforma práctica de inferencia distribuida en GPU, en entornos donde los recursos centralizados son limitados.
La ficha no incluye cifras de rendimiento, modelos evaluados, tamaños de clúster ni comparaciones con otras soluciones, y tampoco detalla la arquitectura. No se puede valorar cuánto rinde el sistema, cómo gestiona la latencia entre equipos ni qué impacto tiene sobre el uso normal de los Mac. Para estos puntos habría que leer el PDF completo.
📚 Para profundizar
Los semiconductores como el petróleo del siglo XXI: historia, espionaje y por qué una isla de 23 millones de habitantes sostiene toda la economía de l

El mejor libro para empezar si no eres técnico: un profesor de Wharton explica cómo trabajar CON la IA —cuándo delegar, cuándo supervisar, cuándo ni t
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- Procedural Graphs: grafos autoevolutivos que enseñan a los agentes LLM «qué hacer» en tareas largas · 2026-09-14
- Harness Policy Distillation: alinear las políticas de los agentes con la semántica del entorno de ejecución · 2026-10-20
- AM-Bench: cómo se comportan los agentes de IA ante tareas incompletas o ambiguas, según modelo y harness · 2026-10-20