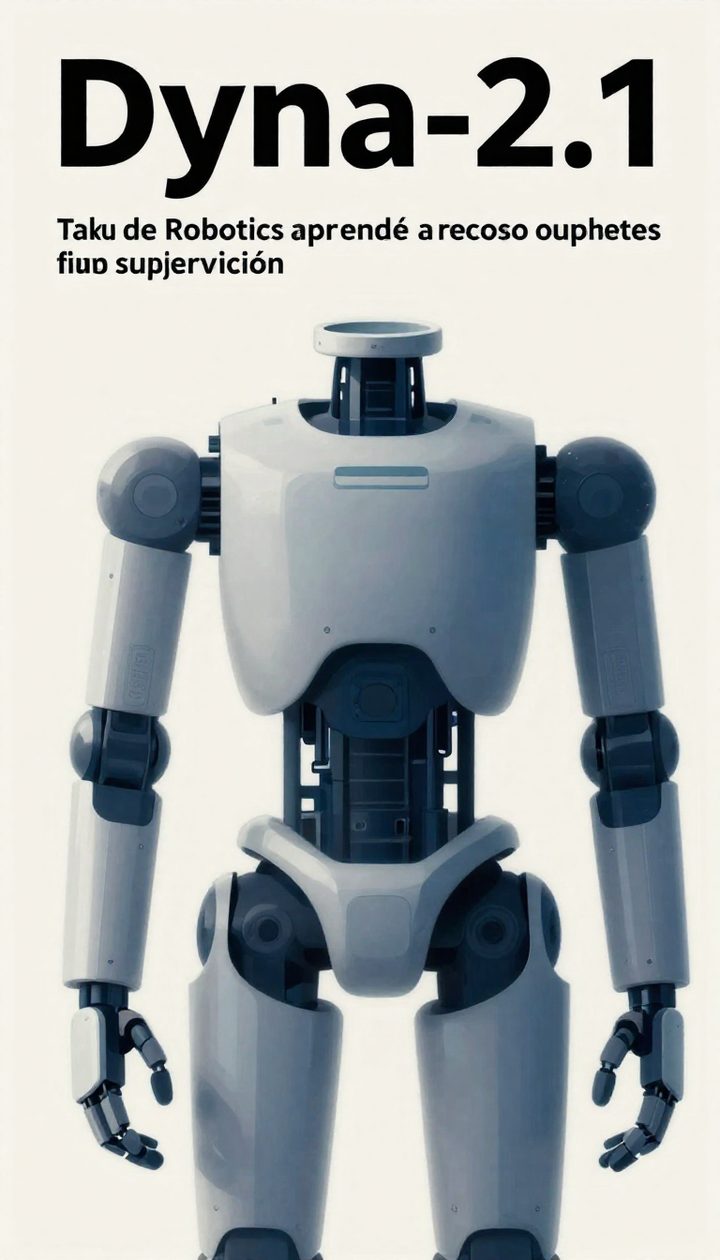
Dyna-2.1: el robot humanoide Taku de Dyna Robotics aprende a ejecutar flujos de trabajo completos sin supervisión
🕒 Publicado en Zendoric: 3 de octubre de 2026 · 02:03
✨ Generado con IA · cómo se hace
Dyna Robotics ha presentado Dyna-2.1, un sistema que la compañía describe como su primer "agente físico" capaz de ejecutar de principio a fin un flujo de trabajo completo —no una tarea aislada— durante horas sin intervención humana frecuente.
📚 Para profundizar

El mejor libro para empezar si no eres técnico: un profesor de Wharton explica cómo trabajar CON la IA —cuándo delegar, cuándo supervisar, cuándo ni t
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
Dyna Robotics ha presentado Dyna-2.1, un sistema que la compañía describe como su primer "agente físico" capaz de ejecutar de principio a fin un flujo de trabajo completo —no una tarea aislada— durante horas sin intervención humana frecuente. El anuncio viene acompañado de un nuevo robot semi-humanoide llamado Taku (del japonés takumi, "maestro artesano") y de un vídeo de una hora sin cortes en el que el sistema completa de forma autónoma el ciclo de trabajo de un cuarto de lavandería de hotel: cargar lavadoras, trasladar ropa a secadoras, doblar toallas, apilarlas y llevarlas a estantes.
El argumento central del artículo es una distinción que la empresa considera clave para el negocio de la robótica: hay una diferencia enorme entre que un robot ejecute bien una tarea estacionaria (doblar servilletas, por ejemplo) y que sustituya a una persona en un rol completo. Según explican, su generación anterior, DYNA-1, ya era capaz de doblar servilletas durante 24 horas sin fallar en esa tarea concreta, pero necesitaba que un humano le rellenara continuamente el cesto de servilletas y retirara las pilas ya dobladas. En cuanto esa persona se ausentaba, el flujo se detenía aunque la habilidad en sí funcionara perfectamente. La conclusión que extraen de hablar con clientes es que estos no pagan por una tarea, sino por un rol: quieren un robot que cubra un turno completo sin un segundo empleado de apoyo permanente.
Para lograrlo, identifican tres capacidades que, según ellos, ningún modelo de acción único sobre una plataforma de hardware limitada puede resolver por separado: ampliar el espacio de trabajo físico del robot (porque los flujos actuales están diseñados para cuerpos humanos que usan base, torso y brazos de forma conjunta en cada estación), la "enseñabilidad" (teachability), es decir, la capacidad de aprender rápido nuevas habilidades y hacerlas fiables a partir de datos humanos, simulación y correcciones recogidas en el propio puesto de trabajo, y el razonamiento, necesario porque los flujos de trabajo reales no son lineales sino que exigen decisiones condicionales constantes. Por eso optan por construir lo que llaman un "agente físico" de pila completa, desde el diseño del hardware hasta el aprendizaje de políticas robustas.
El robot Taku es la pieza de hardware de esta propuesta: un cuerpo con forma humana por encima de la cintura, una parte inferior plegable que le permite alcanzar puntos muy bajos o muy altos, una base estable sobre cuatro ruedas direccionales (en lugar de piernas) y dos brazos con siete grados de libertad cada uno. La empresa explica que, dado que la mayoría de los pasos en los flujos que les interesan requieren alcance y precisión de manipulación más que locomoción bípeda, optaron por ruedas en vez de piernas. El tamaño del robot por encima de las ruedas está calculado para aproximarse al de una persona promedio, de modo que las muñecas, codos y pecho registrados al rastrear a un humano caigan cerca de posturas que Taku también puede alcanzar. Además, los brazos usan actuadores planetarios de baja relación de reducción —en lugar de los motores armónicos habituales en brazos robóticos— para conseguir velocidades y aceleraciones más parecidas a las del movimiento humano. El ejemplo que ponen es ilustrativo: en la lavandería, el robot tiene que inclinarse dentro del tambor de una secadora a la distancia de un brazo, meter la mano en la lavadora para recuperar una toalla olvidada, girar la cintura con una carga encima y agacharse hasta el estante más bajo o estirarse hasta el más alto, todo ello en estaciones separadas por varios metros. A esto lo llaman manipulación "loco-destra" (loco-dexterous), una combinación de movimiento coordinado de todo el cuerpo y manipulación fina que, según argumentan, resulta muy difícil de lograr con un brazo bimanual fijo sobre una mesa o con manipuladores móviles de estilo "elevador".
El artículo insiste en que tener alcance físico sobre todas las estaciones es solo el primer problema. El verdadero reto del flujo de lavandería, dicen, es doble. Por un lado, encadena cientos de subtareas a lo largo de un turno: en una hora ocurren muchos pequeños fallos —una pinza que agarra dos toallas a la vez, una esquina que se dobla mal, una pila que se inclina— y algunos de esos fallos deshacen trabajo previo (una toalla caída debe volver a la lavadora; una pila caída manda de vuelta al principio a todas las toallas que contenía). La compañía reconoce que eligieron la lavandería precisamente porque la mayoría de sus fallos son recuperables, pero cada recuperación cuesta tiempo y, aun así, cada paso debe evitar errores irreversibles, de modo que la fiabilidad por paso se acumula de forma implacable. Ilustran esto con un cálculo: si cada uno de los aproximadamente 79 pasos de un ciclo tiene un 95% de fiabilidad individual —una cifra que en muchos contextos industriales se consideraría buena—, la probabilidad de que el ciclo completo termine sin ayuda humana cae a apenas un 1,7%, lo que en la práctica se traduce en unas 190 intervenciones humanas cada 24 horas, es decir, una cada ocho minutos. Es un argumento potente para explicar por qué la fiabilidad agregada, y no solo la fiabilidad de una habilidad aislada, es el verdadero cuello de botella de la robótica de propósito general.
El segundo problema es que el flujo no es lineal. Aunque las toallas siguen una secuencia simple (lavado, secado, doblado, apilado), el robot no puede seguir esa misma secuencia de forma rígida: cada máquina termina en su propio horario, y una máquina que acaba y se queda esperando sin que nadie la atienda es capacidad perdida. Esto obliga a que el doblado sea una tarea interrumpible: el robot debe vigilar las máquinas mientras dobla ropa y atender a cada una en cuanto termina. El artículo descompone un ciclo completo en trece puntos de decisión, varios de los cuales dependen de información que el robot observó minutos u horas antes pero que ya no es visible en el momento de decidir —por ejemplo, cuándo arrancó la lavadora, qué carga hay en qué máquina o qué estante tiene espacio libre—, lo cual exige una forma de memoria de trabajo a medio plazo que va más allá de la percepción inmediata.
Para resolver estos dos problemas, el sistema se organiza en tres capas de modelos, cada una operando a una escala de tiempo distinta. La primera es un controlador de cuerpo completo, entrenado con aprendizaje por refuerzo en simulación, que convierte trayectorias objetivo en el espacio de tareas (posiciones de muñecas, codos, pecho y base, un formato que denominan Unified Robot Representation o URR) en órdenes concretas de articulaciones y velocidades de ruedas, a una frecuencia de 100 Hz. La segunda capa es la política DYNA-2, una versión mejorada de su modelo mundo-acción ya presentado anteriormente, que traduce el paso actual del flujo en esas trayectorias objetivo de cuerpo completo, operando a unos 5 Hz. La tercera capa es un orquestador de flujo de trabajo, construido sobre un modelo de visión y lenguaje, que hace seguimiento del estado del flujo, decide cuál es el siguiente paso y dirige a la política DYNA-2 para ejecutarlo.
La parte más desarrollada del material disponible se centra en el concepto de "enseñabilidad": lo barato y rápido que resulta llevar una habilidad nueva, o adaptar el procedimiento de un cliente nuevo, hasta un nivel de fiabilidad de producción. La compañía subraya que el dato robótico es el recurso más escaso de todos —cuesta horas de robot y de operador, y cada revisión de hardware deja parcialmente obsoletos los datos recogidos antes—, mientras que la cantidad de experiencia humana registrada (vídeo, captura de movimiento, demostraciones con pinzas de mano) no deja de crecer. Afirman que, gracias a sus avances en enseñabilidad, algunos despliegues de plegado estacionario ya alcanzan el nivel de producción en un nuevo emplazamiento en tan solo tres días, frente a semanas o meses de ingeniería in situ que requerían antes. Con Dyna-2.1 dicen ir más allá, aprendiendo habilidades nuevas con mucha menos demostración previa, y ponen como ejemplos dos habilidades nuevas mostradas en vídeo: atender un servidor informático y recuperar una bebida.
Para lograrlo describen tres decisiones de diseño. La primera es hacer que los datos humanos sean utilizables directamente por los robots mediante esa representación unificada (URR), que describe un cuerpo por las posiciones de muñecas, codos, pecho y base en un marco de referencia local consistente. Según el artículo, esta representación tiene tres propiedades: es agnóstica a la morfología del cuerpo (sirve igual para un humano, un humanoide, un robot semi-humanoide como Taku o un brazo bimanual de mesa, usando más o menos componentes del cuerpo según lo que esté presente), captura las restricciones espaciales más relevantes para la manipulación coordinada (posición de las manos, configuración del brazo, postura del torso y ubicación en el espacio de trabajo) y es reversible respecto a formatos de acción equivalentes, siempre que se conserve el marco de referencia y la postura inicial. La diferencia frente a otros sistemas de teleoperación de cuerpo completo, señalan, es que estos suelen ajustar primero el movimiento humano a las articulaciones concretas del robot antes de que actúe un controlador de seguimiento, lo cual —cuando se aprende a partir de vídeo— puede hacer que la mano objetivo se aleje del objeto que realmente tocaba en el vídeo original, generando una discrepancia entre la imagen y la etiqueta de acción. Al mantener el movimiento demostrado en el espacio de tareas como objetivo y delegar la coordinación articular al controlador, evitan ese problema, y de paso consiguen que tanto la teleoperación en vivo como las grabaciones egocéntricas o las demostraciones con dispositivos tipo UMI entren todas por la misma vía de datos.
Según el texto, tanto el modelo de acción (la política DYNA-2) como el controlador de aprendizaje por refuerzo se entrenan sobre movimiento humano convertido a este formato URR. La política se preentrena con un millón de horas de vídeo humano combinadas con datos de su propia flota de robots, usando como objetivo las poses de cuerpo completo extraídas del vídeo, de modo que el ajuste fino posterior con datos reales de robot solo tiene que enseñarle las particularidades del cuerpo concreto de Taku; el vídeo humano, además, expone al modelo a toallas, máquinas y habitaciones que sus propios datos de robot nunca cubrieron. Como prueba de que este preentrenamiento funciona incluso sin ajuste adicional, citan que DYNA-2, preentrenado solo con vídeo humano, superó el 87% de las pruebas de aceptación de cliente de forma directa (zero-shot) en un robot estacionario desplegado en sitios de los que no tenía datos propios, frente a un 46% de su generación anterior, DYNA-1.
El texto también explica que el controlador de cuerpo completo y la tarea de aprendizaje forman un ciclo que se retroalimenta: más demostraciones producen un controlador mejor, y un controlador mejor permite registrar demostraciones de mayor calidad para entrenar la política. El controlador aprende equilibrio, postura y seguimiento de movimiento mediante aprendizaje por refuerzo en simulación, donde los ensayos son baratos, y en lugar de depender únicamente de exploración y de un ajuste manual de recompensas, reutiliza el enorme volumen de datos URR como objetivos de postura junto con objetivos sintéticos, para inyectar directamente patrones de postura humana natural en el aprendizaje de control. La compañía afirma haber observado que este creciente conjunto de datos humanos no solo acelera la convergencia del entrenamiento, aunque el documento se interrumpe exactamente en ese punto, antes de completar la explicación de ese beneficio y sin llegar a desarrollar los apartados siguientes que el propio índice del artículo anuncia: cómo se conserva la utilidad de datos de robot antiguos pese a los cambios de hardware, el resultado final en términos de dominio de habilidades y de recuperación ante errores, el funcionamiento detallado del orquestador basado en modelo de visión y lenguaje (incluida su memoria de largo plazo), el apartado de perspectivas de futuro y la lista de referencias citadas.
Conviene dejar claro, por tanto, que el contenido descargado de la fuente llega truncado a mitad de frase en la sección dedicada al entrenamiento del controlador, y que no se trata de un muro de pago sino de un corte en la captura del artículo original. Todo lo anterior refleja fielmente lo que sí aparece en el texto disponible; cualquier detalle sobre las secciones finales —enseñabilidad ante cambios de hardware, el balance final de fiabilidad conseguido, el diseño exacto del orquestador o las conclusiones de la compañía sobre los próximos pasos— no puede confirmarse con el material recibido y queda fuera de este resumen para no especular sobre cifras, afirmaciones o ejemplos que no constan literalmente en el documento.
📚 Para profundizar

La historia de NVIDIA y Jensen Huang: cómo una empresa de tarjetas para videojuegos acabó fabricando el recurso más codiciado del planeta.
Los semiconductores como el petróleo del siglo XXI: historia, espionaje y por qué una isla de 23 millones de habitantes sostiene toda la economía de l
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- Moonshot presenta Kimi K3, el mayor modelo abierto del mundo, y China estrecha la brecha de IA con EE.UU. · 2026-07-18
- Demios lanza un 'gemelo digital' que reparte tu trabajo entre agentes: la promesa es ambiciosa, la prueba todavía no · 2026-07-25
- Nueva York frenó a la robot-profesora 'Sally' en 24 horas: lo hizo el periodismo, no la ley · 2026-07-28