Un chatbot puso cazas en el aire: la alucinación que casi provoca un incidente naval con China
🕒 Publicado en Zendoric: 25 de septiembre de 2026 · 03:17
✨ Generado con IA · cómo se hace
Un informe de inteligencia asistido por IA afirmó falsamente que un buque chino llevaba componentes de un programa de armas nucleares, y EE.UU. llegó a preparar el abordaje con aviones ya en vuelo, según CNN. El fallo no fue que el modelo se equivocara —eso es lo que hacen los modelos—, sino que nadie puso fricción entre un texto probabilístico y una decisión militar.
📚 Para profundizar
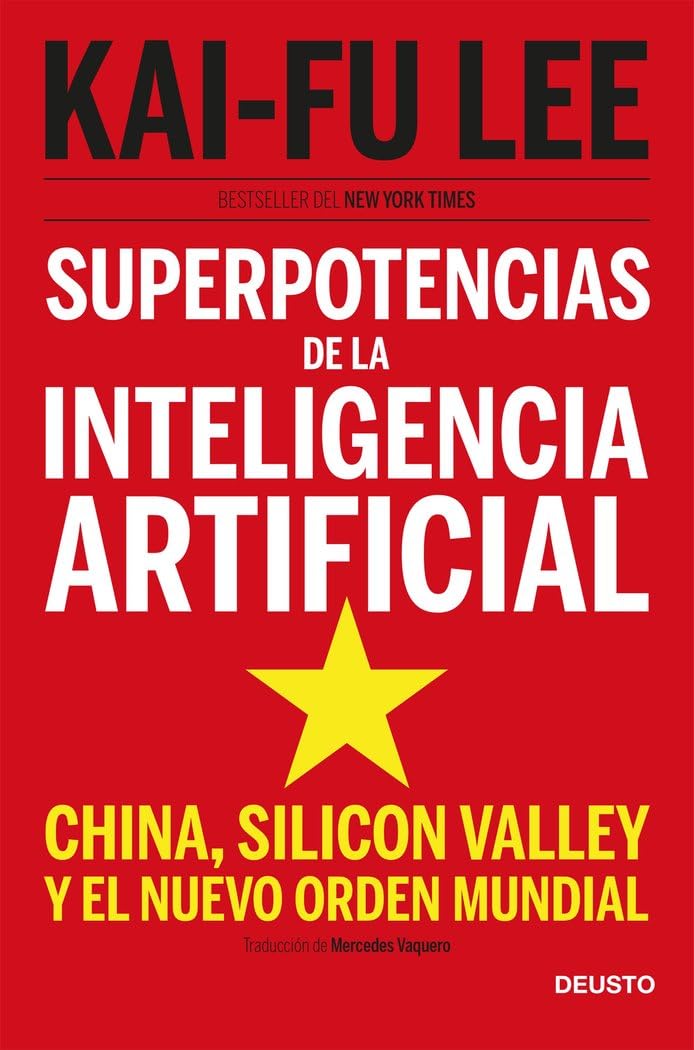
China contra Silicon Valley contado por quien dirigió Google China y ha invertido en ambos lados.
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
El Ejército de EE.UU. estuvo a punto de lanzar una operación contra un barco chino a partir de un informe de inteligencia asistido por IA que resultó ser falso. Según CNN, que cita a cuatro fuentes conocedoras del episodio y a quien recoge Benzinga, el informe circuló esta primavera —con la guerra con Irán en curso— y sostenía que un buque chino que atravesaba Oriente Medio transportaba componentes vinculados a un programa de armas nucleares. La respuesta fue inmediata: personal armado preparado para abordar y aviones militares ya en el aire. Solo después, al revisar la inteligencia, se descubrió que un chatbot utilizado por un analista del Mando de Operaciones Especiales había identificado mal la carga. Una de las fuentes describe el informe como «enteramente falso» y afirma que «casi empieza una guerra». El Departamento de Guerra no respondió a la petición de comentario de Benzinga.
El detalle técnico importa más que el titular. Según el relato de CNN, el analista pidió al chatbot que analizara información sobre el manifiesto del buque, y el sistema combinó fuentes abiertas con inteligencia de señales clasificada antes de que las conclusiones se incorporaran a un informe de inteligencia estándar. Ahí está el punto de fallo real: una alucinación —texto estadísticamente plausible pero inventado— entró en un documento con el formato, el sello y la autoridad de un producto de inteligencia humano. En ese trasvase se perdió la etiqueta de «esto lo generó un modelo y no está verificado». El error no se propagó por ser sofisticado, sino por quedar lavado en la cadena de custodia documental.
El contexto es de escala. El Pentágono está acelerando la adopción de IA en toda la operativa militar y ha ampliado su plataforma GenAI.mil, que ya ofrece versiones gubernamentales de Google Gemini, Grok y ChatGPT de OpenAI. Una fuente citada por CNN sostiene que alucinaciones como esta se han convertido en un problema recurrente en la comunidad de inteligencia a medida que las herramientas se extienden por las agencias. Tras la publicación, senadores demócratas pidieron a los organismos de control que investiguen presuntos errores relacionados con IA en planes de objetivos militares; en una carta al secretario de Defensa, Pete Hegseth, y al director de Inteligencia Nacional, Jay Clayton, advirtieron de que se está priorizando la adopción rápida sobre una supervisión eficaz. Son acusaciones de los firmantes, no hechos probados.
Nuestra tesis: el problema no es la IA en inteligencia, es la ausencia de fricción proporcional al riesgo. Que un modelo generativo se equivoque no es una anomalía corregible con la siguiente versión; es una propiedad estadística de la tecnología. Lo que sí es corregible —y barato comparado con un incidente naval— es el proceso: marcado obligatorio de cada fragmento generado por IA, trazabilidad de la fuente de cada afirmación y doble verificación humana explícita en cualquier producto que pueda desencadenar uso de la fuerza. Ninguna de esas tres cosas requiere frenar la adopción; requiere ingeniería de procedimiento. Que no estuvieran ahí en un flujo que mezcla fuentes abiertas con SIGINT clasificada dice más de la prisa institucional que del modelo.
Y conviene no leerlo como un argumento contra la IA militar, porque el volumen de datos que hoy procesa una comunidad de inteligencia ya no es abordable a mano: la automatización va a quedarse. La lectura útil es otra, y enlaza con algo que venimos sosteniendo: el autocontrol no basta y la gobernanza solo sirve si es verificable. Aquí el mecanismo que funcionó no fue técnico ni preventivo, fue humano y tardío —alguien revisó el informe a tiempo—, y el que se ha activado después es el escrutinio parlamentario y periodístico. A largo plazo, esta tecnología tiene todo el sentido en análisis de inteligencia igual que lo tiene en diagnóstico médico. Pero en ambos casos el valor solo aparece cuando el sistema está obligado a mostrar por qué afirma lo que afirma. Nota irónica y pertinente: el propio artículo de Benzinga declara haber sido producido parcialmente con herramientas de IA y revisado por editores humanos. Esa combinación —máquina que redacta, humano que responde— es exactamente el modelo que faltó aguas arriba.
📚 Para profundizar

La investigación periodística definitiva sobre OpenAI: más de 260 entrevistas, el choque entre seguridad y velocidad, y el intento de despido de Sam A
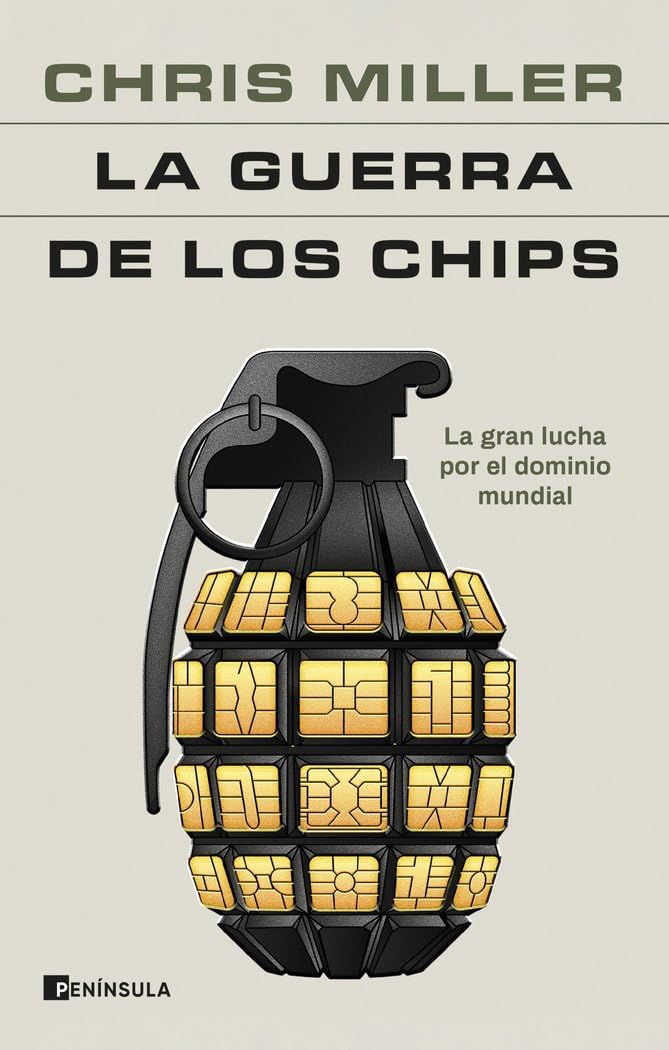
Los semiconductores como el petróleo del siglo XXI: historia, espionaje y por qué una isla de 23 millones de habitantes sostiene toda la economía de l
Como Afiliado de Amazon, Zendoric obtiene ingresos por compras adscritas; el precio no cambia para ti. · todos nuestros libros recomendados →
🔗 Relacionadas en Zendoric
- El fallo no fue la alucinación: un chatbot llegó a un informe de inteligencia sin cadena de verificación · 2026-09-23
- Un chatbot casi desata un incidente con China: la IA militar necesita fricción, no velocidad · 2026-09-26
- La IA militar china preocupa a Washington: la disuasión también se libra en los modelos · 2026-06-27